Fabio Steyer · Berlin
Über mich
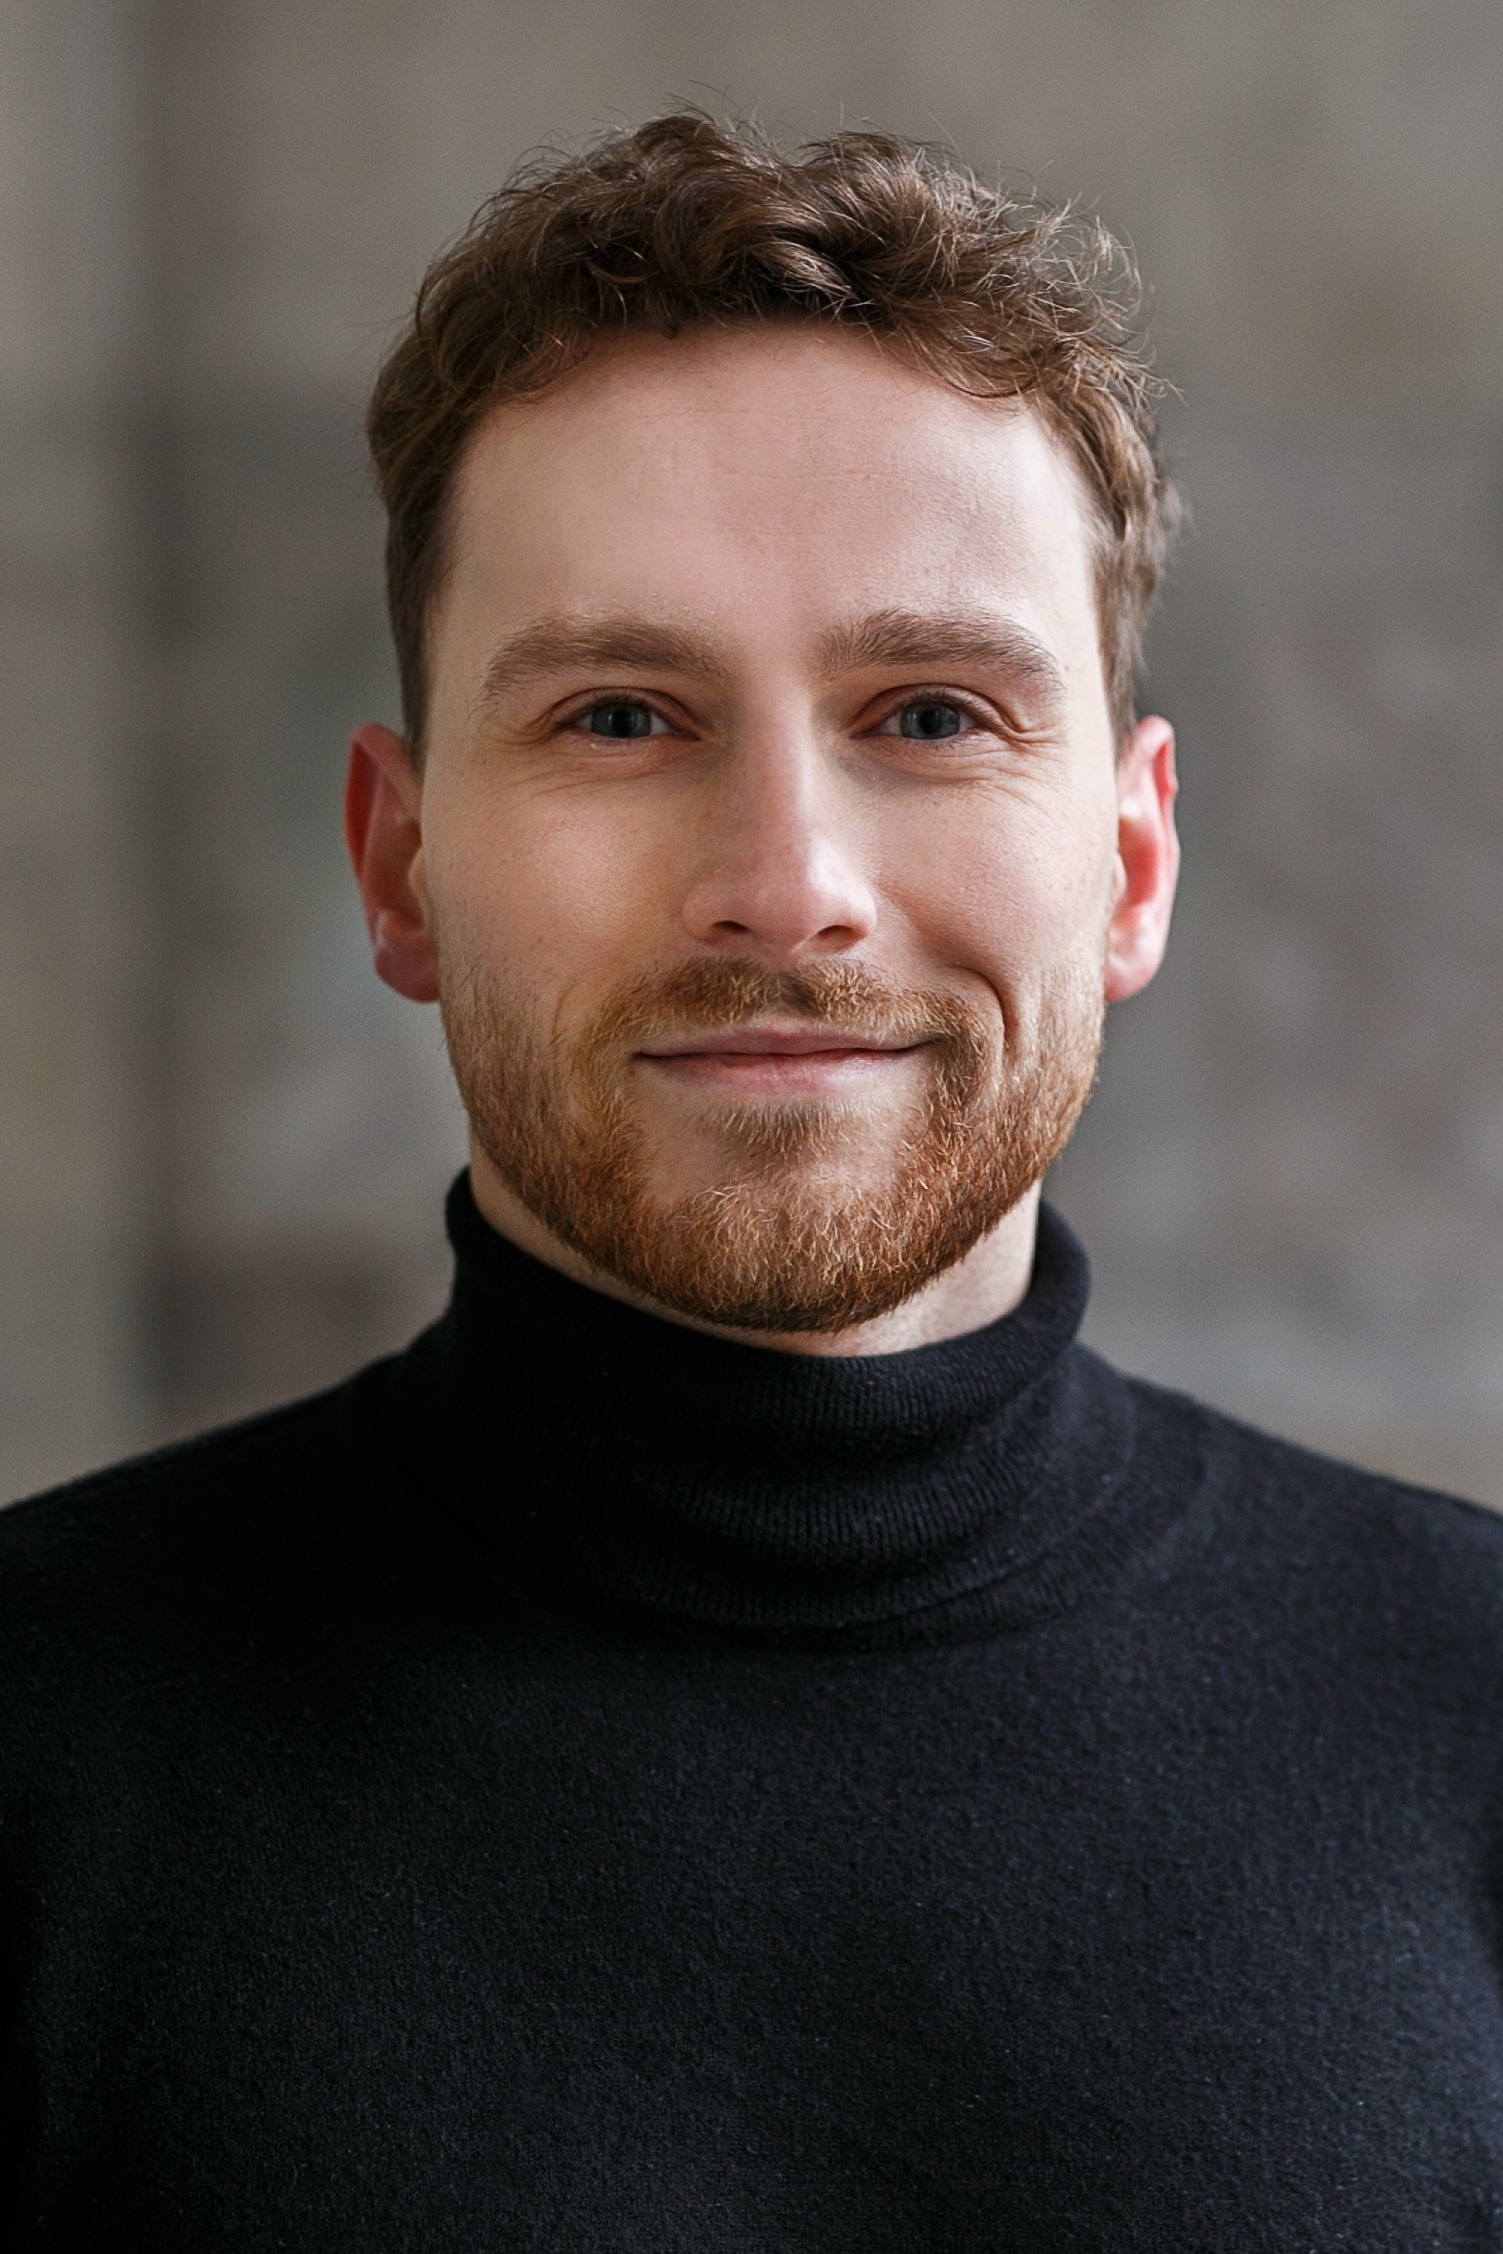
Ich bin Physiker im Masterstudium an der TU Berlin und arbeite seit 2025 an der Schnittstelle von Datenanalyse und Prozessautomatisierung. Was mich an dieser Arbeit interessiert, ist die Entscheidung vor dem Code: welcher Schritt ein Skript braucht, welcher ein Sprachmodell, und welcher besser gar nicht automatisiert wird.
Fähigkeiten und Belege
Jede Zeile nennt, worauf sie sich stützt. „Lernstand" heißt: vorhanden, aber nicht durch ein Projekt belegt.
| Fähigkeit | Beleg | Stufe |
|---|---|---|
| Python | Produktive Pipelines bei Cavator; alle fünf Python-Projekte unter Projekte | öffentlich belegbar |
| Document Parsing | invoice-quote-reconciliation, gegen eine Wahrheitstabelle gemessen | öffentlich belegbar |
| Nebenläufigkeit und Datenintegrität | concurrent-file-writes, Vergleichslauf mit und ohne Koordination | öffentlich belegbar |
| Testdisziplin | 104 Tests über fünf Python-Projekte, inklusive Mehrprozessläufen | öffentlich belegbar |
| Wissenschaftliche Datenauswertung | B.Sc.-Arbeit, Spektroskopie und Modellanpassung | öffentlich belegbar |
| OCR | Rund 3.000 Rechnungen und Angebote bei Cavator, nicht öffentlich | praktisch genutzt |
| LLM-Integration (Claude, OpenAI) | Eingebaut in eigene Pipelines im Betrieb; die Prüfkette in prose-check-chain ist gebaut, aufgezeichnete Modellantworten fehlen noch | praktisch genutzt |
| Git | Sechs Repositories mit nachvollziehbarer Historie | praktisch genutzt |
| SQL | Eigene Übungen, im Aufbau | Lernstand |
Zur KI-Unterstützung
Ich arbeite mit KI-Werkzeugen, auch beim Bau dieser Seite. Die fachlichen Entscheidungen, die Auswahl der Inhalte und deren Prüfung liegen bei mir.